

חדשות הבינה המלאכותית השבוע מצביעות על שינוי ברור. התחרות כבר לא עוסקת רק בשאלה איזה מודל חכם יותר.
מהירות, עלות, חיבור לכלים, פרטיות ועבודה עם כמה סוכנים הופכים חשובים לא פחות.
השוק עובר ממודלים שמייצרים תשובות למערכות שמבצעות עבודה. זאת אומרת, הערך העסקי נקבע לפי חוויית העבודה המלאה, ולא רק לפי תוצאה במבחן.
מעולה לראות את קצב החדשנות, אבל עדיין צריך לבדוק כל הכרזה מול שימוש אמיתי, אבטחה ותוצאה עסקית.
אחד העדכונים הבולטים בסקירה הוא מצב מהיר במיוחד למודל מתקדם של OpenAI. לפי הדיווח, המודל רץ באמצעות Cerebras, ספקית תשתית שמפתחת שבבים ייעודיים להרצת מודלים במהירות גבוהה.
בדוגמה שהוצגה, סוכן קוד בנה לוח בקרה בסגנון מסוף פיננסי. הגרסה המואצת השלימה את המשימה בתוך פחות משתי דקות. הגרסה הרגילה נזקקה ליותר משתים עשרה דקות באותה הדגמה.
הפער נשמע טכני, אבל הוא משפיע ישירות על העבודה. מפתח שממתין זמן רב לכל משימה נאלץ להפעיל כמה סוכנים במקביל. לאחר מכן הוא עובר ביניהם, זוכר את ההקשר ובודק את התוצאות.
כאשר הסוכן מגיב במהירות, אפשר להפעיל פחות תהליכים במקביל. כך יורד עומס המעבר בין משימות, והעבודה הופכת רציפה יותר. אני ממש אוהב את הכיוון הזה, כי הוא מתקרב לאופן שבו אנשים באמת רוצים לעבוד.
ההתקדמות מעלה נקודה מעניינת. בעבר דיברנו בעיקר על מגבלות של כרטיסים גרפיים ושל כוח חישוב בענן. כעת, כאשר המודל מייצר פלט במהירות גבוהה, המחשב המקומי וכלי התוכנה צריכים להדביק את הקצב.
חיבורי מערכת, קריאות לפונקציות והפעלת קוד עדיין דורשים תשתית מסורתית. במקרים מסוימים, המודל כבר לא מעכב את התהליך. דווקא המעבד, הרשת או השירות החיצוני יוצרים את ההמתנה.
למה? למה זה טוב לנו? סוכנים מהירים מאפשרים לבנות תהליכי עבודה קצרים ולבדוק יותר רעיונות. מצד שני, מהירות לבדה אינה מספיקה. אם הסוכן מייצר שגיאות מהר יותר, קיבלנו בעיה מהירה יותר.
עדכון נוסף מתייחס ל־Grok 4.6 ולמוצר בשם Grokbot. לפי הסקירה, המוצר מנסה לקחת יכולות של סוכן קוד ולהציג אותן בצורה פשוטה יותר.
המשתמש אינו חייב לראות את הקוד, לבחור מודל או להחליט על רמת החשיבה. הוא מגדיר מטרה, והמערכת מנסה לבצע את העבודה. בנוסף, המוצר מתחבר לכלים כמו Slack, Google Docs ודואר אלקטרוני.
הגישה הזו חשובה לקהל רחב. רוב המנהלים ואנשי התפעול אינם רוצים לנהל תהליך טכני מורכב. הם רוצים שהמערכת תאסוף מידע, תנסח מסמך, תעדכן מערכת ותבקש אישור כאשר צריך.
לפי הדיווח, כל שיחה יכולה לתפקד כסוכן נפרד. סוכנים שונים יכולים גם לדבר זה עם זה ולחלק ביניהם משימות. זה מזכיר צוות קטן של עובדים דיגיטליים, אבל דורש הרשאות, בקרה והגדרת אחריות ברורה.
עסק לא צריך להתחיל מעשרה סוכנים. עדיף לבחור תהליך אחד שחוזר על עצמו, למדוד את זמני העבודה ולבדוק היכן סוכן יכול לעזור.
העיקרון פשוט. הסוכן צריך לפתור בעיה מוגדרת. הוא לא צריך לקבל גישה לכל מערכות הארגון כבר ביום הראשון.
Anthropic הודיעה על שימוש אפשרי בסימון נסתר בפלט של מודלים ממשפחת Claude. לפי ההסבר, הסימון נשען על הדרך שבה המודל בוחר את המילה הבאה.
בכל שלב קיימות כמה מילים אפשריות. המודל בוחר אפשרות סבירה לפי ההקשר. מנגנון סימון המים משנה את מקור האקראיות בהחלטות קטנות. כך נוצר דפוס שאינו נראה לקורא, אך ניתן לזיהוי באמצעות מפתח מתאים.
החברה מסבירה שהסימון משמעותי בעיקר כאשר Claude כותב חלק גדול מהטקסט. כאשר המודל רק מגיה טקסט שנכתב בידי אדם, רוב המילים נשארות של המשתמש. לכן יש פחות חומר לסימון.
בקוד, השפעת הסימון אמורה להיות מוגבלת בעיקר למקומות שבהם קיימת בחירה שרירותית, כמו הערות או שמות מסוימים. עם זאת, כל שינוי בדרך בחירת המילים עשוי להשפיע על הפלט.
כאן נדרשת זהירות. סימון כזה עשוי לעזור בזיהוי תוכן שנוצר במודל ולתמוך בדרישות רגולטוריות. במקביל, הוא מעלה שאלות על פרטיות, מעקב ושליטה בתוכן שהמשתמש יוצר.
הנושא קשור גם לדרישות שקיפות באירופה. אפשר לקרוא את סעיף 52 בחוק הבינה המלאכותית האירופי כדי להבין את הרקע. לפני פרסום סופי, מומלץ לבדוק את הנוסח המשפטי העדכני ואת תחולת החוק על הארגון.
אני חשוב בתהליך הזה, אבל לא כמי שמקבל אוטומטית כל טענה של חברה. המשתמש צריך לדעת מה נאסף, מה נשמר, מי יכול לזהות את התוכן ומה ניתן לכבות. אפילו שאני בעד שקיפות, שקיפות צריכה לעבוד בשני הכיוונים.
השבוע כלל כמה שחרורים של מודלים פתוחים או בעלי משקלים פתוחים. לפי הסקירה, GLM 5.3 הציג שיפור לעומת הגרסה הקודמת במשימות קוד ובבדיקות עבודה עם מסוף.
DeepSeek V4 Pro הוצג כמודל חזק וזול יחסית. נקודה מעניינת היא תמחור משתנה לפי שעות עומס ושימוש חוזר בהקשר. כאשר המערכת משתמשת במטמון, עלות הקלט עשויה לרדת משמעותית.
המשמעות העסקית ברורה. ארגונים יכולים להכניס יותר מידע להקשר, להריץ תהליכים רבים יותר ולבחון שימושים חדשים בלי להגדיל את התקציב באותו יחס.
Meta הציגה גם את Muse Glimmer, מודל קטן יותר שמיועד להרצה מקומית. מודל של כשלושים מיליארד פרמטרים מתאים יותר למחשב חזק או לכרטיס גרפי מתקדם, ולא רק לתשתית ענן.
המודלים האלה אינם חייבים להתחרות במודל החזק ביותר. הם יכולים להתאים למשימות ממוקדות, להרצה בתוך הארגון או לשימוש במכשיר. מדהים לראות איך השוק מתפצל למודלים גדולים מאוד ולמודלים יעילים ונגישים.
בוחרים משימה חוזרת עם תוצאה שקל למדוד. לדוגמה, איסוף נתונים, הכנת תקציר או מיון פניות. לא מתחילים מהטכנולוגיה, אלא מהבעיה.
משווים זמן תגובה, עלות לכל משימה ושיעור תיקונים. מודל מהיר וזול לא יעזור אם העובדים צריכים לתקן כל פלט.
נותנים לסוכן רק את הגישה שהוא צריך. פעולות כספיות, משפטיות או רגישות דורשות אישור אנושי ותיעוד ברור.
שומרים היסטוריה של החלטות, שגיאות ושינויים. לאחר שהתהליך יציב, אפשר להרחיב אותו בזהירות לתהליכים נוספים.
עדכון נוסף שנדון בסקירה הוא Computer History של OpenAI. הרעיון הוא לתעד את פעולות המשתמש במחשב ולזהות תהליכים שאפשר להפוך לאוטומטיים.
הפיצ'ר מוצג כאפשרות שמופעלת בהסכמה, עם שליטה על האפליקציות או סוגי המידע שמשותפים. אפשר לבחור לשתף דפדפן, גיליונות עבודה או יישומים מסוימים. אפשר גם להשאיר את האפשרות כבויה.
הכיוון מזכיר את Recall של Microsoft, שעורר ביקורת סביב אבטחה ופרטיות. ההבדל החשוב אינו רק אם הפיצ'ר מופעל. צריך לבדוק היכן המידע נשמר, מי ניגש אליו וכמה זמן הוא נשמר.
אני ממש רוצה לראות אוטומציה שמבינה את שגרת העבודה שלי. אז, כדי שזה יהיה שימושי באמת, המערכת צריכה להציע הצעות ברורות ולא לפעול מאחורי הקלעים ללא אישור.
| כיוון | מה הוא מציע | מה חשוב לבדוק |
|---|---|---|
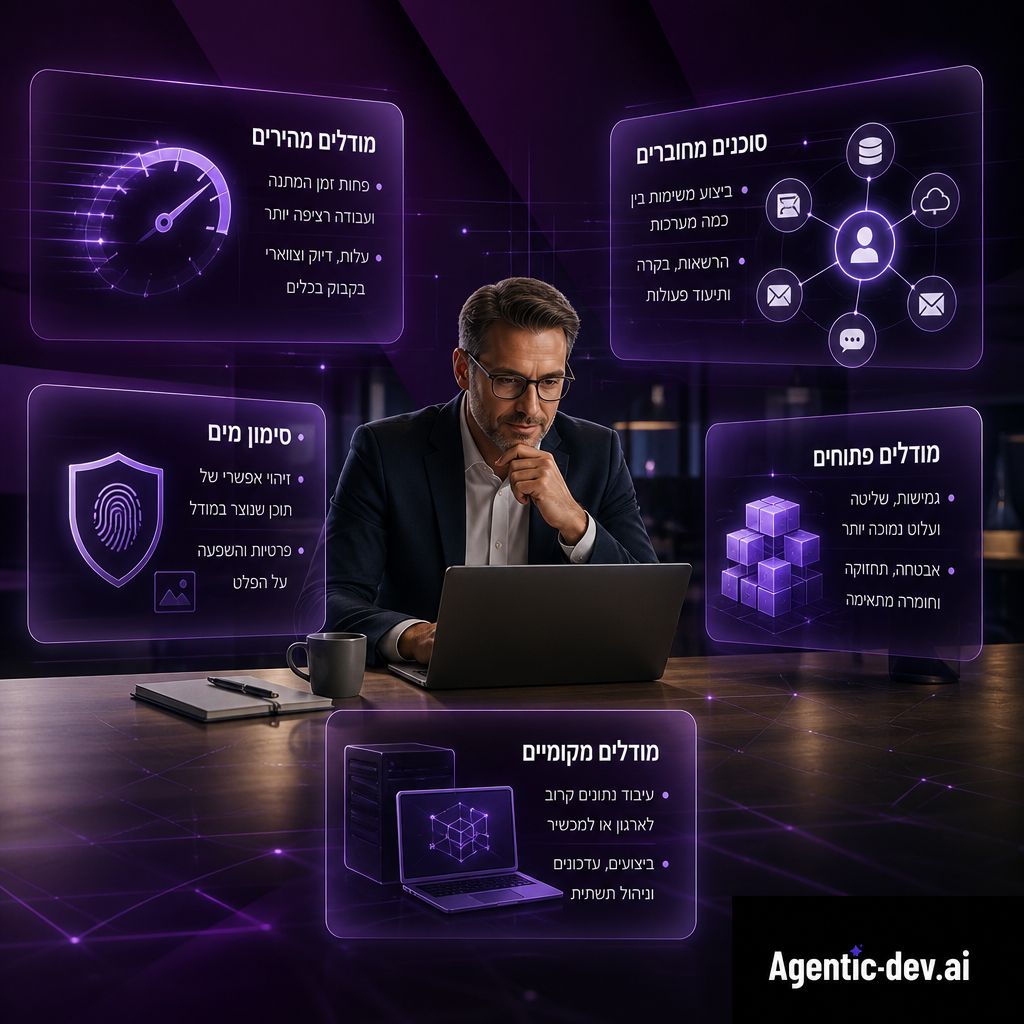
| מודלים מהירים | פחות זמן המתנה ועבודה רציפה יותר | עלות, דיוק וצווארי בקבוק בכלים |
| סוכנים מחוברים | ביצוע משימות בין כמה מערכות | הרשאות, בקרה ותיעוד פעולות |
| סימון מים | זיהוי אפשרי של תוכן שנוצר במודל | פרטיות והשפעה על הפלט |
| מודלים פתוחים | גמישות, שליטה ועלות נמוכה יותר | אבטחה, תחזוקה וחומרה מתאימה |
| מודלים מקומיים | עיבוד נתונים קרוב לארגון או למכשיר | ביצועים, עדכונים וניהול תשתית |
חדשות הבינה המלאכותית אינן מחייבות כל עסק לרוץ ולהטמיע כל מוצר חדש. הן כן מחייבות מנהלים לעדכן את דרך החשיבה שלהם על תשתיות, תהליכים וסיכון.
בנוסף, כדאי להשוות בין מודלים פתוחים, שירותי ענן וסוכנים מוכנים. לכל אפשרות יש מחיר שונה של גמישות, תחזוקה ושליטה.
החיבור בין מודלים מהירים לסוכנים מעשיים הוא כנראה הכיוון החשוב ביותר. הוא משפיע על זמן העבודה, על מבנה הצוותים ועל הדרך שבה מפתחים מערכות.
לא. מהירות חשובה כאשר התהליך כולל המתנות רבות, אך צריך לבדוק גם דיוק, עלות, אבטחה ואיכות התוצאה.
זהו דפוס נסתר שנוצר במהלך בחירת מילים. הוא אמור להיות בלתי נראה לקורא, אך ניתן לזיהוי באמצעות מנגנון מתאים.
מודל פתוח יכול להתאים כאשר העסק צריך שליטה, פרטיות או הרצה מקומית. עם זאת, העסק צריך יכולת לתחזק את המודל ולבדוק את רמת האבטחה שלו.
מתחילים ממשימה אחת, מגדירים תוצאה ברורה ומגבילים את ההרשאות. לאחר מכן מודדים ביצועים ומרחיבים רק כאשר התהליך יציב.
חדשות הבינה המלאכותית השבוע מציגות שוק שנע במהירות לכיוון של מערכות פעילות, ולא רק צ'אטים חכמים. מודלים מהירים יותר, סוכנים שמתחברים לכלים, מודלים פתוחים וזולים וסימון תוכן יוצרים יחד מציאות חדשה עבור עסקים ומפתחים.
המסר המעשי פשוט: אל תמדדו רק את המודל. בדקו את כל סביבת העבודה, כולל מהירות, עלות, הרשאות, פרטיות ותוצאה עסקית.
למה זה טוב לנו? אם פועלים ביושרה, בפשטות ובסקרנות, אפשר ללמוד מהר ולבנות נכון. אני ממש אוהב חדשנות, אבל עדיין חשוב לזכור שהטכנולוגיה צריכה לשרת את העבודה, את האנשים ואת המטרה. איזה כיוון בחדשות הבינה המלאכותית ישפיע לדעתכם הכי הרבה על העבודה בחודשים הקרובים?


