
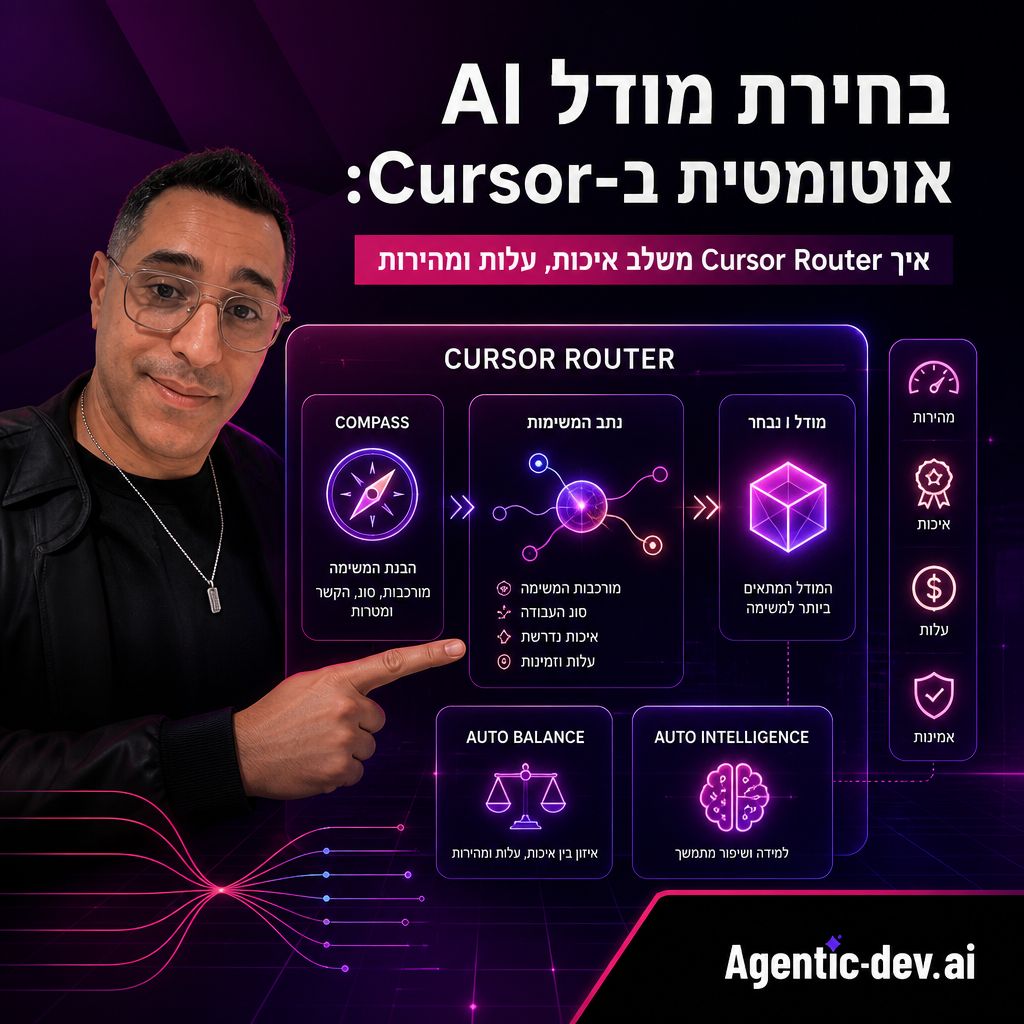

בחירת מודל AI אוטומטית ב-Cursor פותרת בעיה יומיומית של מפתחים: לא כל משימה צריכה את המודל החזק והיקר ביותר.
בקשה קצרה, כמו יצירת קומיט, שונה מאוד מתכנון ארכיטקטורה או איתור באג מורכב.
Cursor Router מנתח את המשימה, את הקשר השיחה ואת דפוסי השימוש. זאת אומרת, הוא מנסה לבחור בכל פעם את המודל שמתאים לצורך האמיתי.
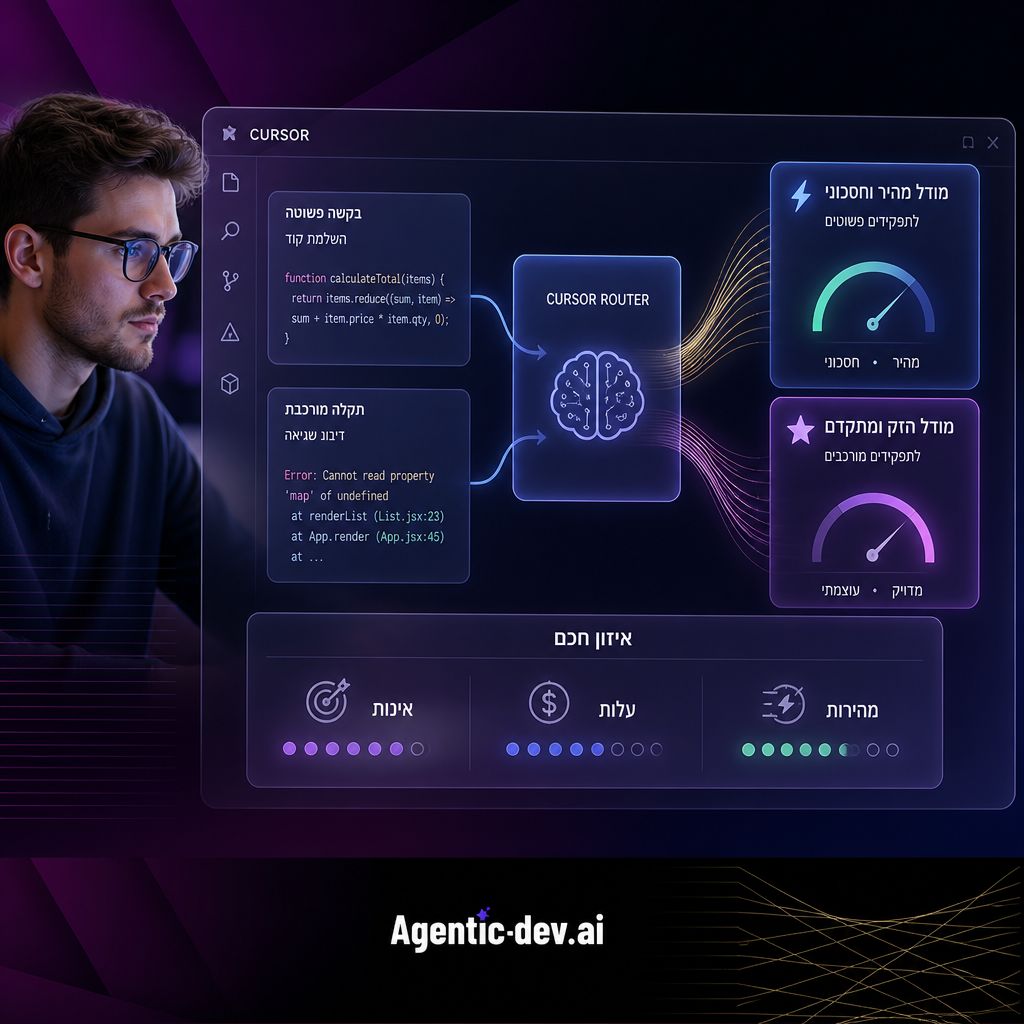
מפתח יכול לבקש מהעוזר ליצור קומיט, לכתוב בדיקות, לשנות עיצוב או לייעל שאילתת מסד נתונים.
לכל משימה יש רמת מורכבות אחרת. שימוש במודל חזק בכל פנייה מגדיל עלויות בלי להבטיח ערך נוסף.
מצד שני, מודל זול מדי עלול להחזיר פתרון חלקי. במקרה כזה המפתח נאלץ לתקן, להסביר מחדש ולעבוד שוב על אותה משימה.
למה? למה זה טוב לנו? ניתוב נכון מתאים את המשאב לצורך ומפחית עבודה מיותרת.
הטענה המרכזית פשוטה: מערכת ניתוב טובה אינה שואלת איזה מודל הכי חזק באופן כללי.
היא שואלת איזה מודל מתאים למשימה הנוכחית, להקשר שלה ולמחיר של טעות.
לפי הנתונים שפורסמו, Auto Intelligence מספק שביעות רצון ברמה דומה ל-Fable, בעלות נמוכה ממנו ב-68%.
Auto Balance מציג ביצועים טובים יותר מ-Opus 4.8, בעלות נמוכה ממנו ב-41%. הנתונים משקפים השוואות שפרסמה Cursor.
אפשר לקרוא על יכולות המוצר והעדכונים שלו גם בתיעוד הרשמי של Cursor. כדאי לבדוק את המידע העדכני לפני שמגדירים מדיניות שימוש בארגון.
Cursor Router אינו נשען רק על מבחני ביצועים. הוא לומד מתעבורת שימוש אמיתית של מפתחים.
הגישה הזאת חשובה, משום שמבחן מעבדה אינו תמיד משקף שיחה ארוכה, שימוש בכלים או מעבר בין מודלים.
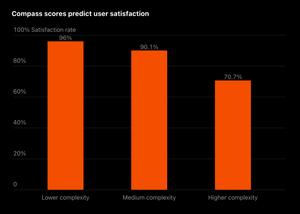
התרשים משווה את שיעור שביעות הרצון של משתמשים לפי רמת המורכבות: ציר ה־X מציג מורכבות נמוכה, בינונית וגבוהה, וציר ה־Y מציג שיעור שביעות רצון באחוזים. ככל שהמורכבות עולה, שביעות הרצון יורדת — מכ־95% במורכבות נמוכה לכ־71% במורכבות גבוהה — כך שההבדל המעשי הבולט הוא הקשר השלילי בין מורכבות המשימה לבין חוויית המשתמש.
המערכת בוחנת את הפנייה הנוכחית ואת השיחה האחרונה. היא מתייחסת לסוג המשימה, לקריאות לכלים, להקשר הרחב ולדפוסי ההמשך של המשתמש.
הנתונים כוללים מאות אלפי פניות ממגוון מודלים. לפי Cursor, האיסוף מתבצע בהתאם להגדרות הפרטיות ושמירת הנתונים של המשתמשים.
במקום להסתמך רק על ציון חיצוני, Cursor בוחנת מה המשתמש עושה אחרי תשובת המודל.
מעבר למשימה הבאה נחשב סימן חיובי. תיקון של הסוכן או בקשה חוזרת נחשבים סימנים שליליים יותר.
המדד אינו מושלם, אבל הוא מחובר להתנהגות אמיתית. אם המשתמש ממשיך לעבוד, יש סבירות שהתשובה הייתה שימושית.
אם הוא מתקן שוב ושוב, ייתכן שהמודל לא הבין את המשימה או לא ביצע אותה היטב.
Compass הוא מנגנון חיזוי שמעריך את הסבירות שהמשתמש יהיה מרוצה מתשובת המודל.
הוא מפיק ציון רציף בין 0 ל-1. הציון משמש קירוב לרמת המורכבות של המשימה.
משימה פשוטה, כמו יצירת קומיט, בדרך כלל אינה גוררת בקשת תיקון.
משימה מורכבת עשויה לדרוש שאלות המשך, שינויים ותיקונים. לכן דפוסי שביעות רצון יכולים לסמן קושי.
בבדיקה מקוונת, פניות שקיבלו את דירוג ההצלחה הגבוה ביותר מ-Compass קיבלו אות חיובי ב-96% מהמקרים.
פניות שקיבלו את הדירוג הנמוך ביותר קיבלו אות חיובי ב-71% מהמקרים.
כאשר Compass מזהה פנייה מורכבת, המערכת מנסה לבחור מודל חזית מתאים.
לשם כך היא משתמשת בטקסונומיה שנלמדה מתעבורת פיתוח אמיתית.
הטקסונומיה מתארת כל פנייה בשלושה ממדים:
החלוקה הזאת מראה שאין מודל אחד שמוביל בכל סוגי המשימות.
מודל אחד יכול להצטיין בתכנון, בעוד מודל אחר יתאים יותר לניפוי שגיאות או לשינויים חזותיים.
הנתונים של Cursor מצביעים על הבדלים בין המודלים. Grok מספק ערך טוב בעבודה רחבה ושגרתית.
עלות ההסקה הנמוכה שלו הופכת אותו מתאים לפקודות Git ולפעולות כלליות במסדי נתונים.
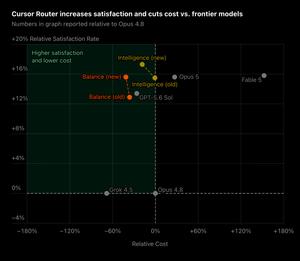
ציר ה־X מציג את העלות היחסית וציר ה־Y את שיעור שביעות הרצון היחסי, שניהם בהשוואה ל־Opus 4.8: שמאלה פירושו זול יותר, ולמעלה פירושו שביעות רצון גבוהה יותר. הנקודות הכתומות הן מצבי Cursor Router, והאפורות הן מודלי חזית להשוואה; קווי האפס מסמנים את הביצועים של Opus 4.8.
הנקודה המרכזית היא שהאפשרויות הכתומות נמצאות ברובן מעל קו האפס ובצד הזול שלו, בעוד שחלק ממודלי החזית האפורים עולים יותר בלי יתרון מקביל בשביעות הרצון. כלומר, התרשים מצביע על כך שניתוב בין מודלים לפי סוג המשימה עשוי לשפר את חוויית המשתמש ובו בזמן להפחית עלויות, אף שהתרשים עצמו אינו מפרט כיצד נמדדה שביעות הרצון או את סוגי המשימות שהובילו לכל נקודה.
Sol מציג ביצועים חזקים בתכנון ובהבנת בסיסי קוד. הוא מתאים גם למגוון משימות מימוש, בעלות נמוכה מזו של מודלים מתקדמים אחרים.
Opus מפגין חוזקה בעבודה ביצועית. בין התחומים שבהם הוא בולט נמצאים DevOps, שאילתות למסדי נתונים ואופטימיזציית ביצועים.
Fable מתאים במיוחד לניפוי שגיאות ולמימושים חזותיים. היתרון שלו משמעותי יותר במשימות מורכבות, שבהן השיפור באיכות מצדיק את העלות הגבוהה יותר.
השם של המודל פחות חשוב מסוג העבודה. אני ממש אוהב את הגישה הזאת, כי היא מחליפה דיון כללי בהחלטה ממוקדת לפי צורך.
לאחר ש-Compass מעריך את הקושי, המערכת בוחרת בין שני מסלולים.
פנייה פשוטה יחסית נשלחת למודל חסכוני. פנייה מורכבת עוברת לנתב המשימות.
המערכת אינה מנתבת פנייה למודל יקר רק משום שהוא זמין. מועמד נכנס לתהליך הבחירה רק כאשר הנתונים מצביעים על שיפור ברור לעומת המודל החסכוני.
לפי ההסבר של Cursor, הסף מבוסס על דרישת שיפור חד-צדדית של 75% בביצועים.
לאחר מכן, אופטימייזר בוחר את שילוב המודלים שמספק את השיפור הגדול ביותר במסגרת תקציב המצב.
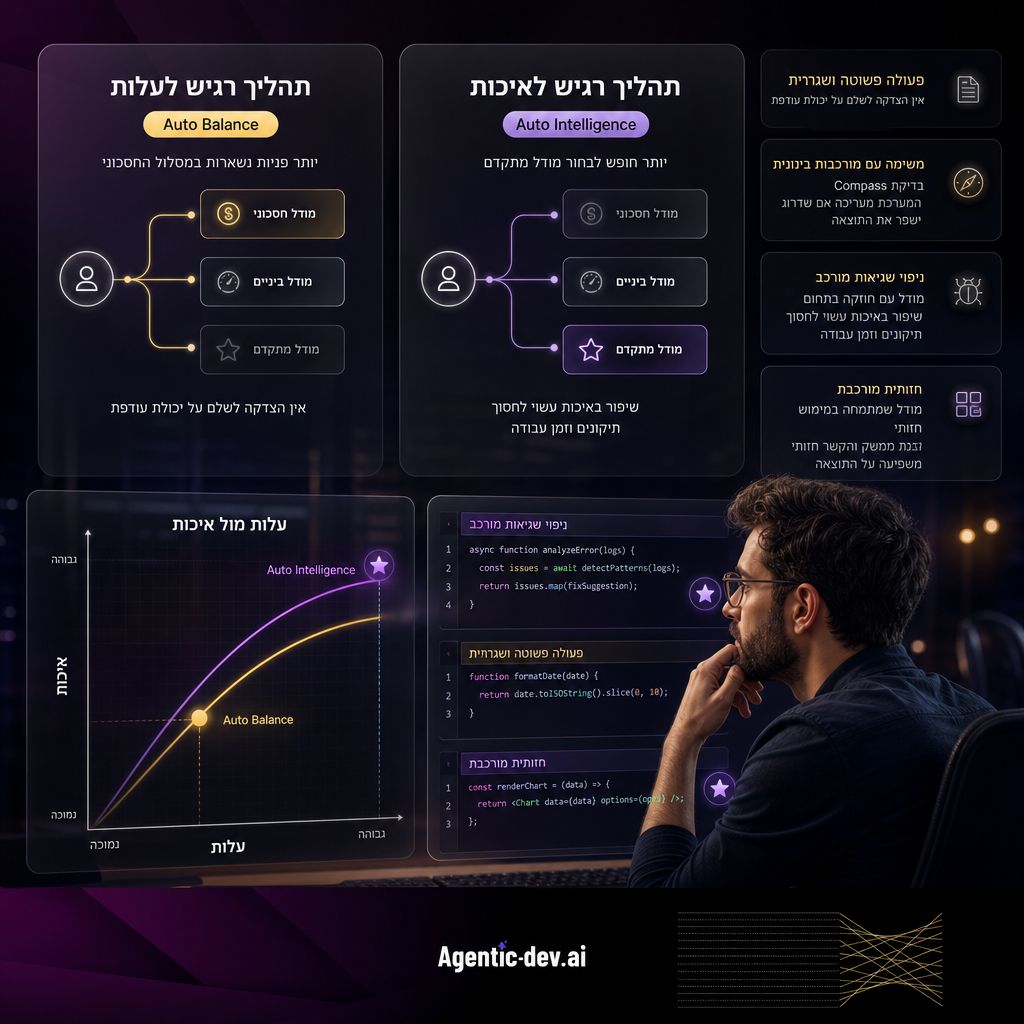
Auto Balance משאיר יותר פניות במסלול החסכוני ומקצה תקציב קטן יותר לנתב המשימות.
הוא מתאים למי שרוצה איכות גבוהה תוך שליטה הדוקה יותר בעלות.
Auto Intelligence מאפשר לנתב להשתמש יותר במודלים חזיתיים כאשר השיפור הצפוי מצדיק זאת.
הוא מתאים למי שמעדיף למקסם איכות, גם כאשר העלות הממוצעת מעט גבוהה יותר.
שני המצבים נשענים על אותם עקרונות, אך נמצאים בנקודות שונות על עקומת העלות והביצועים.
לכן הבחירה תלויה בסוג העבודה, בתקציב ובחשיבות של כל פנייה.
הלקח אינו מוגבל ל-Cursor. כל ארגון שבונה מערכת AI יכול ליצור שכבת החלטה שמבינה את סוג הבקשה ואת המחיר של טעות.
אני חשוב כמשתמש וכמקבל החלטות, אבל עדיין המערכת צריכה למדוד תוצאות ולא רק תחושות.
כדאי לבדוק אם המשתמש התקדם, אם נדרש תיקון, כמה טוקנים נצרכו ומה הייתה עלות הפנייה.
בנוסף, חשוב למדוד את העלות האמיתית. מעבר בין מודלים עלול ליצור החמצות מטמון ולהגדיל שימוש בטוקנים.
נתוני עבודה אמיתיים יכולים לחשוף את העלויות האלה, בעוד שבנצ'מרק פשוט עלול להתעלם מהן.
| סוג הפנייה | מסלול מתאים | היגיון מרכזי |
|---|---|---|
| פעולה פשוטה ושגרתית | מודל חסכוני | אין הצדקה לשלם על יכולת עודפת |
| משימה עם מורכבות בינונית | בדיקת Compass | המערכת מעריכה אם שדרוג ישפר את התוצאה |
| ניפוי שגיאות מורכב | מודל עם חוזקה בתחום | שיפור באיכות עשוי לחסוך תיקונים וזמן |
| עבודה חזותית מורכבת | מודל שמתמחה במימוש חזותי | הבנת ממשק והקשר חזותי משפיעה על התוצאה |
| תהליך רגיש לעלות | Auto Balance | יותר פניות נשארות במסלול החסכוני |
| תהליך רגיש לאיכות | Auto Intelligence | יותר חופש לבחור מודל מתקדם |
Cursor משתמשת בשני שלבי הערכה. בשלב הראשון היא מפעילה אימות צולב כדי לכוון את ספי Compass ואת תקציבי האופטימיזציה.
בשלב השני היא בוחנת את המדיניות על קבוצת בדיקה שלא שימשה לאימון.
כך מתקבלת הערכה אמינה יותר של הביצועים הצפויים על תעבורה חדשה.
גם הערכה לא מקוונת אינה מספיקה. תנאי ייצור כוללים שיחות ארוכות, שימוש בכלים, מטמון, צריכת טוקנים ומעברים בין מודלים.
לכן בדיקה על תעבורת מפתחים חיה היא שלב קריטי. מודלים חדשים מגיעים, מחירים משתנים ודפוסי שימוש מתפתחים.
אפילו שאני מעדיף תהליך פשוט, כאן חייבים להישאר סקרנים וללמוד מהנתונים.
מאז השקת Cursor Router נוספו מודלים חדשים, ובהם Opus 5, וגם תחזיות Compass השתפרו.
השילוב בין מגוון רחב יותר לבין חיזוי טוב יותר מאפשר למערכת לקבל החלטות מדויקות יותר.
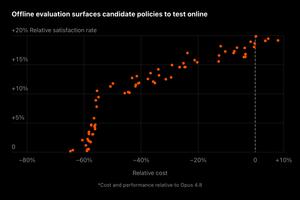
כל נקודה כתומה מייצגת מדיניות מועמדת שנבדקה בהערכה לא־מקוונת: הציר האופקי מציג את השינוי היחסי בעלות, והציר האנכי את השינוי היחסי בשיעור שביעות הרצון, לעומת נקודת הייחוס. הערכה לא־מקוונת משתמשת בנתונים או בסביבה מדומה לפני ניסוי על משתמשים אמיתיים; לכן הגרף נועד לסנן מועמדים ולהחליט אילו מהם ראויים לבדיקה מקוונת.
הפיזור מצביע על פשרה ברורה: בתחילה אפשר לקבל שיפור גדול בשביעות הרצון כמעט בלי להגדיל את העלות, אך בהמשך השיפורים נעשים מתונים יותר ונקודות עם שביעות רצון גבוהה יותר נוטות לעלות גם יותר. כלומר, ההבדלים החשובים אינם בין נקודות סמוכות אלא לאורך חזית הבחירה — כמה תוספת עלות מצדיק השיפור הצפוי בשביעות הרצון; התוצאות הלא־מקוונות מסייעות למצוא מועמדים מבטיחים, אך אינן מוכיחות עדיין את ביצועיהם בפועל.
הכיוון העתידי הוא מערכת אדפטיבית יותר. מערכת כזאת תחזה לכל מודל את האיכות והעלות הצפויות, תלמד מתוצאות הייצור ותעדכן את החלטותיה לאורך זמן.
המשמעות עבור מפתחים היא גישה למודלים חזקים כאשר באמת צריך אותם, בלי לשלם מחיר של מודל חזיתי בכל פנייה.
זה מעולה למשתמש הבודד, ומהמם במיוחד עבור צוותים וארגונים שמנהלים שימוש רחב ב-AI.
לא. המערכת בוחרת את המודל שמתאים ביותר למשימה במסגרת תקציב העלות והביצועים.
מודל חזק יותר אינו בהכרח הבחירה היעילה ביותר עבור פעולה פשוטה.
לפי הנתונים שפורסמו, כן. Auto Intelligence פועל בעלות נמוכה משמעותית מ-Fable, ו-Auto Balance זול משמעותית מ-Opus 4.8.
התוצאה בפועל תלויה בדפוסי השימוש, באורך השיחות ובסוג המשימות.
Auto Balance נותן עדיפות גדולה יותר למסלול החסכוני.
Auto Intelligence מאפשר יותר שימוש במודלים חזיתיים כאשר המערכת צופה שיפור משמעותי באיכות.
Compass לומד מדפוסי הצלחה וסימני שביעות רצון. הוא בוחן את הפנייה ואת ההקשר שלה, ואז מעריך את הסבירות שתשובת המודל תספק את המשתמש.
המערכת נבנתה על מגוון משימות פיתוח, כולל צד שרת, מסדי נתונים, ממשקי משתמש, בדיקות, DevOps וניפוי שגיאות.
עדיין, כל ארגון צריך לבדוק את התוצאות מול המשימות והנתונים שלו.
בחירת מודל AI אוטומטית ב-Cursor מבוססת על רעיון מעשי: לא כל פנייה זקוקה לאותו מודל.
Compass מעריך את מורכבות המשימה, נתב המשימות מזהה את תחום העבודה, והאופטימייזר מחבר בין איכות לבין תקציב.
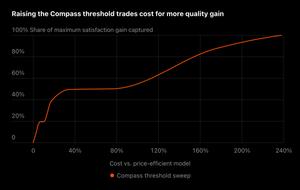
הציר האופקי מציג את העלות ביחס למודל היעיל־במחיר, באחוזים, והציר האנכי מציג כמה מהשיפור המרבי בשביעות הרצון נתפס. הקו הכתום הוא סריקה של סף Compass: ככל שמעלים את הסף, משקיעים יותר חישוב כדי להשיג איכות גבוהה יותר. צורת העקומה מצביעה על תשואה שולית פוחתת בתחילה — שיפור מהיר בעלות נמוכה — ולאחר מכן על אזור כמעט שטוח, עד שהשיפור חוזר ומצטבר בעלויות גבוהות בהרבה. המשמעות המעשית היא שהגעה לשיפור האיכות המרבי אינה זולה: נקודת האיזון תלויה בכמה איכות נוספת מצדיקים מול עלות החישוב.
הגישה הזאת מראה כיצד מערכת AI יכולה להשתפר באמצעות נתוני שימוש אמיתיים.
אני ממש רוצה לראות יותר מערכות שפועלות כך, כי הן מאפשרות לארגונים ליהנות מיכולות מתקדמות בלי לוותר על שליטה בעלויות.
אז המסר החשוב פשוט: במקום לבחור מודל אחד לכולם, בנו מנגנון שיודע לבחור נכון בכל פעם.
איזה חלק בתהליך הניתוב האוטומטי הייתם רוצים ליישם קודם אצלכם?


